本页目录 · 9 节
Orbi 做的事是:你给 GitHub issue 打上 ai-ready,它还你一个评审过、已经合并的 PR。代码平常由 Pi 编程 agent 来写,Orbi 用命令行启动它,主要是两种角色:实现会话改代码,评审会话审 PR。Pi 进程之外的事都归 Orbi 的 runner 管。runner 是一个定时轮询 GitHub 的调度程序,负责挑 issue、让实现和评审各用各的会话、决定什么能合并、卡住了怎么救。Pi 是 Earendil 做的开源项目,MIT 协议(earendil-works/pi),Orbi 跟 Earendil 没有关系。
我是 Lawrence Liu,Orbi 的维护者。Orbi 是开源的,Orbi Cloud 托管的是同一个 runner。Cloud 知道哪些 PR 被合并,靠的是 GitHub 的 webhook,不是 runner 上报,而且只限装了 Orbi GitHub App 的仓库。从 9 月 16 日第一条记录到 10 月 5 日 15:36(北京时间),Cloud 记下了 373 个合并的 PR。这不是 Orbi 合并的全部:我机器上的 runner 做的那些,只有一部分在里面。这 373 个里,20 个在 Cloud 用户的 9 个仓库里,剩下的几乎都在 Orbi 自己的仓库里,Orbi 的代码本来就是 Orbi 交付的。有 169 次交付在 Cloud 上有带 token 数的用量记录,都是在 Pi 会话里写的,本文的数字都来自它们。
这是我们 Pi 系列里讲 Orbi 架构的第一篇(文末链接的两篇 harness 测评也属于这个系列)。先跟着一张 issue 把 Orbi 为它起的每个 Pi 会话走一遍,再讲命令行、169 次交付花了多少(按 DeepSeek 闲时公开价,每次 token 花费中位数 0.082 美元),以及 Pi 留给用户自己搭的部分。有三个词后面会反复出现:Pi 会话是一个 pi --print 进程;run 是 runner 对一张 issue 的一次尝试,有一个 run_id,里面可以起好几个 Pi 会话;恢复这次 run 时沿用同一个 run_id(#1554 被我重新排队后就是这样),重新尝试则换一个新的;交付指最后由 Orbi 合并了 PR 的 issue。
一张 issue 从头到尾
挑的是 orbi#1554,因为这个 bug 就出在 Orbi 跟 Pi 打交道的地方。Pi 从一个叫 models.json 的文件里读模型和 API key。Orbi 每次 run 都往 worktree 的 .orbi/pi-agent/ 下写一份自己的副本,这样每个 run 可以用不同的 provider 配置,又不动机器上 Pi 本身的配置。以前 Orbi 会先把 $VAR 形式的 key 引用解析掉,把真 key 写进这份副本。这个目录在 gitignore 里,key 从没进过提交,但每个 worktree 里都躺着明文 key。代码里有条注释,是 9 月 4 日我们用 Pi 0.84.4 时写的,说 Pi 不会展开这种引用。可早一个版本的 Pi 0.84.3,文档就写得清清楚楚:apiKey 支持 $ENV_VAR 和 ${ENV_VAR}。修法很简单,引用原样保留,让 Pi 自己展开。我 03:21 开的票,打上 ai-ready 就去睡了。
issue 上的时间线(北京时间,都在 10 月 5 日,周一)。注意第一行:我开 #1554 之前,main 就已经红了。
| 时间 | 发生了什么 |
|---|---|
| 00:20 | main 上两个文档测试开始挂,一个在 test_docs_site.py,一个在 test_docs_i18n.py。Orbi 的 CI 工作流自动为它们开了 orbi#1552。 |
| 03:21 | 开票,打上 ai-ready。 |
| 03:26 | Orbi 的 runner 给 #1552 打上 ai-needs-detail,要求补充信息再做。 |
| 03:31 | runner 认领 #1554,起了实现会话(run 598a0fb3)。 |
| 03:43 | 实现会话已经提交了修复,但它自己跑的测试挂在了从 00:20 起就在 main 上挂着的那两个文档测试上。runner 把这个结果贴到 issue 上,照样推送分支、开了 PR #1555,把失败留给评审。 |
| 03:47 | CI 挂在同样这两个测试上。03:51 runner 起了一个评审会话去修。 |
| 04:08 | CI 又挂在这两个测试上,这次跑的是评审推上去的一个提交,里面是一段说明这次改动的文档,跟挂掉的测试无关,后来随 PR 一起合了进去。04:11 runner 又起了一个评审会话。 |
| 04:22 | 这个会话判 PR 通过,runner 进入合并。合并闸门看到 PR 的检查还是红的,就去看 base 提交上同样的检查:main 也挂着,tests 和 macos-compatibility 两项,这两个 job 跑的都是整套测试,包括那两个文档测试。检查没过的 PR 闸门不合,runner 把 issue 标成 ai-blocked。 |
| 12:06 | Orbi 交付了 #1552,main 上这两个测试都修好了。 |
| 13:39 | 我把 ai-blocked 换成 ai-fix-needed,#1554 回到队列。(PR 还开着,所以用 ai-fix-needed,不用 ai-ready。) |
| 13:41 到 13:58 | 新起的评审会话先把新的 main 合进分支,再审 PR,一条意见没有,通过。runner 合了 PR。 |
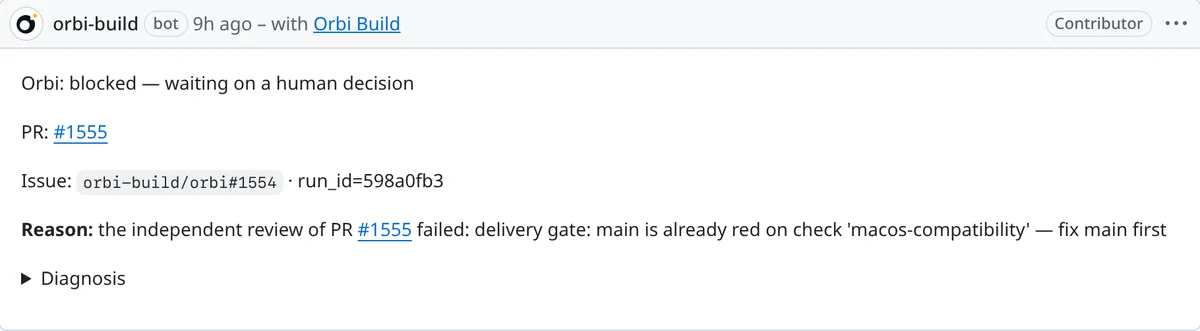
03:51 到 04:22 那两个评审会话是白跑的。它们想修的失败来自 main,main 已经有自己的票,最后修好它的也是那张票。runner 只在合并闸门这一步、也就是评审之后,才把 PR 挂掉的检查跟 base 对比。它本来可以早得多就知道:03:31 认领 #1554 时,main 已经红了三个小时,#1552 就开着。认领时先停一停,或者在 03:43 实现会话自测失败时、03:47 CI 第一次变红时就对比,两个评审会话都能省下。这些 Orbi 现在都还没做。
04:22 之后那九个小时,主要耽误在我身上。#1552 一直挂着 ai-needs-detail,我 11:33 才补上信息,12:06 Orbi 合了修复。接下来 #1554 又在等我重新排队:ai-blocked 从不自动解除,因为下一步可能是改票或关票,不一定是重试。04:22 到 13:41 之间,#1554 没有任何 Pi 会话在跑。
这张票一共起了 4 个 Pi 会话,1 个实现、3 个评审。按 Orbi Cloud 的用量记录,Pi 跑了 51 分钟,发了 164 次模型请求,输出 10.8 万 token,缓存读取 841 万 token,模型都是 deepseek-flash(DeepSeek-V4.1-Flash)。四个会话都不在 DeepSeek 的高峰时段,按公开价整张票大约 0.12 美元。
Orbi 怎么调用 Pi
每个 Pi 会话都是一个 pi --print 进程;Cloud 上的 runner 现在用的是 10 月 1 日发布的 Pi 1.0。去掉提示词正文,命令长这样(见 src/orbi/pi_command.py):
pi [--no-tools] [--no-extensions [--extension <白名单里的扩展>]] \
   [--skill <路径> ...] \
   [--provider <p>] [--model <m>] [--thinking <级别>] \
   --print --session-dir <本次 run 的目录> \
   --system-prompt <角色提示词> <issue 上下文>
扩展白名单写在 Orbi 的配置里。Cloud 上它只有一项,就是 Pi 自带的 Codemode 扩展,所以实现和评审会话带着 --no-extensions 也照样有 Codemode。runner 的 Pi 设置里还另外打开了 Codemode 这个工具,光加扩展是不会打开的(「如果你也想无人值守地跑 Pi」一节有细说)。
实现会话带工具,加载 Orbi 交付用的 skill(其中有 tdd-dev,先写会失败的测试再写代码),用实现模型。动代码之前它先写 .orbi/plan.md:目标、看过哪些文件、要做的任务、拿什么命令验证。然后在这张 issue 的 worktree 里改代码、跑测试,停在一次 commit 上。
评审会话是对着 PR 另起的。它的活是审这一份 diff,有问题就在这份 diff 上修到能合,所以 03:51 那个评审推过提交。Orbi 不给它传两个 skill:tdd-dev 会把它带去从头实现这张票;review-fix-loop(审、修、再审,直到没问题)会在会话里再套一层评审循环,而 runner 外面已经在跑一层了。评审可以单独配模型(review_pi_provider、review_pi_model),结束时必须输出一行 REVIEW_VERDICT {...} JSON,Orbi 解析的就是这一行。
还有第三种角色叫答复,只在 issue 上回答问题,什么都不改。实现和评审会话都带 --no-extensions(原因见下面第一个事故),答复会话带 --no-tools,却完全不传扩展参数,所以它会加载这个系统用户(跑 runner 的那个操作系统用户)装的所有 Pi 扩展。Cloud 上 runner 的系统用户一个都没装,但自己部署的机器上这是个口子,下面第一个事故里那种扩展也会被它加载。skill 也有类似的口子:Orbi 不传 --no-skills,系统用户级的 skill 目录里有什么,每种角色都会自动加载;仓库里的 skill 目录在 Pi 信任这个项目之后也一样,包括 Orbi 特意不给评审的那些。
每个 run 有自己的会话目录,就是 worktree 里的 .pi-session/,Pi 把会话写成 JSONL 放在里面,一条消息或一个工具结果占一行。run 失败时,Orbi 把最近最多 20 条记录的结构摘要(时间、角色、工具,不含正文)附到失败评论里,能看出会话停下时在干什么。run 跑着的时候,Orbi 也一直读这个文件,更新 issue 上的那条进度评论(orbi#24):
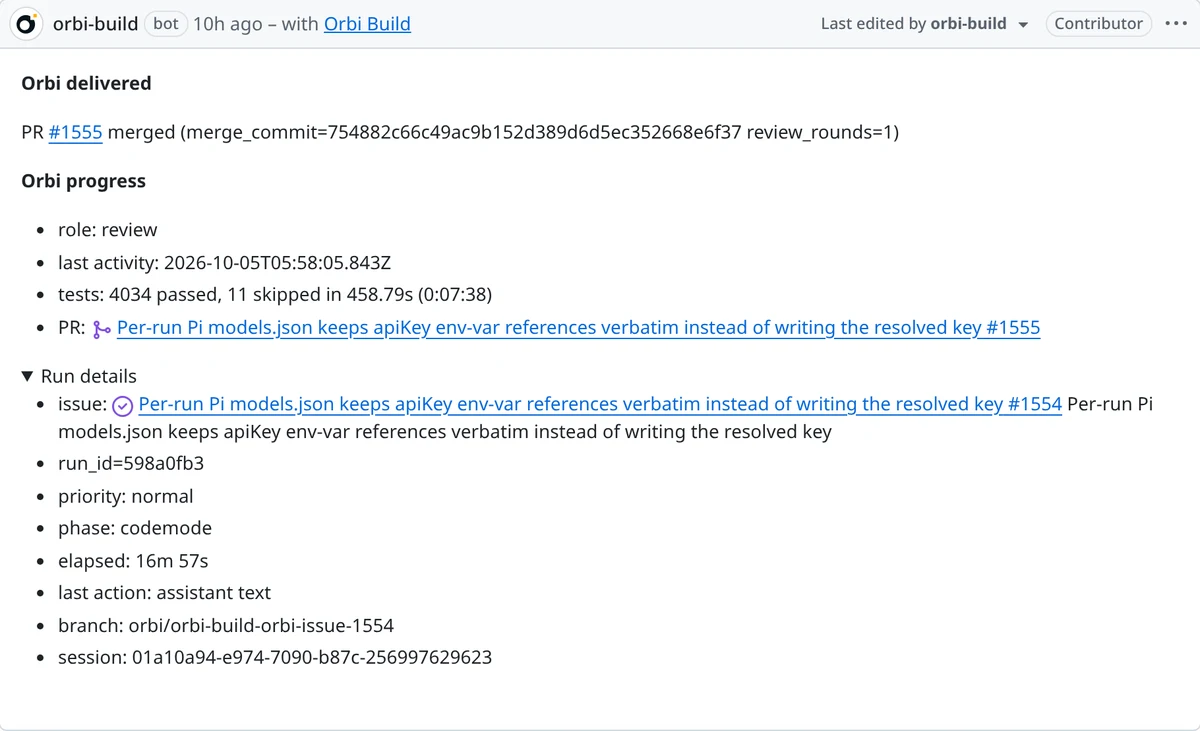
角色、PR 链接、测试结果和评审轮数是 runner 填的;最后活动时间、会话 id 和 phase 是从会话文件里读的。phase 看着像阶段,其实记的是最近一次工具调用;codemode 指 Pi 1.0 的 Codemode:模型写一小段脚本,一次串起好几个工具调用。一个 PR 最多评审 5 轮,用完 Orbi 就停下来找人。评审轮数不等于起过几个评审会话。runner 给一轮记下评审结果,这一轮才算数。前面那两个评审会话,一个结束时 CI 还在跑;另一个判了通过,但在 runner 记下这一轮之前,合并闸门就因为 main 已红把它拦了下来。两个都没被记下,所以 13:41 那次评审是第 1 轮。elapsed 是最后那个会话的用时,不是整张 issue 的。
在 Orbi Cloud 上,真正的 pi 外面还套了一层很薄的包装,每个会话结束后重读一遍会话文件,累加 token 用量。下一节的数字就是这么来的。自己部署的 Orbi 没有这层包装,会话文件是一样的。
169 次交付花了多少
这层包装只在 Cloud 上有,9 月中旬才开始记录(最早一行是 9 月 16 日);Orbi 自己的仓库原先用的是我机器上的开源版 runner,orbi 在 9 月 22 日、orbi-cloud 和 orbi-website 在 10 月 2 日才迁到 Cloud。所以用量记录覆盖的交付比上面的 373 个少。10 月 5 日 15:36(北京时间)查的时候,里面有 170 次交付,其中 169 次有 token 数,模型全是 deepseek-flash。
用量记录每个 issue 和分支只有一行:同一个 run 恢复时会累加,但同一分支上新的一次尝试会把它覆盖掉。Cloud 另外还按每次尝试存了一行,我拿它核对了被覆盖掉的部分:169 次里只有 7 次有过更早的尝试,其中 3 次有 token 数,把它们加回来,花费的中位数和九成位置的值都不变(0.082 美元和 0.22 美元);另外 4 次没记下 token 数,花了多少不知道。加回来的那 3 次会改变合计,表后面会说。表里其余各行,算的都是最后一次尝试。
这 169 次里,141 次在 Orbi 自己的三个仓库,11 次在我们组织下的 fork 和测试仓库,17 次在 Cloud 用户的 7 个仓库。用户仓库那 17 次的中位数是 0.090 美元,跟整体差不多。
表里每一行单独算:把 169 次交付按这一项从小到大排开,取中间的值(一半的交付不超过它)和 90% 位置的值(九成的交付不超过它)。所以同一列的几个数不是同一次交付。花费那一行是先算出每次交付的总价再排序,不是把上面几行加起来。
| 每次交付 | 一半的交付不超过 | 九成的交付不超过 | #1554 |
|---|---|---|---|
| Pi 会话数 | 2 个 | 3 个 | 4 个 |
| Pi 运行时间(各会话相加) | 35 分钟 | 89 分钟 | 51 分钟 |
| 模型请求 | 107 次 | 235 次 | 164 次 |
| 输出 token | 约 7.0 万 | 约 18.8 万 | 约 10.8 万 |
| 未命中缓存的输入 token | 约 13.3 万 | 约 30.3 万 | 约 23.2 万 |
| 缓存读取 token | 约 672 万 | 约 1,909 万 | 约 841 万 |
| 花费(闲时价) | 0.082 美元 | 0.22 美元 | 0.12 美元 |
一般的交付是两个会话,通常就是一个实现加一个评审。#1554 的 4 个会话超过了 90% 位置的值,运行时间和请求数没有超过。
花费按 DeepSeek 公布的 deepseek-flash 价格算,我们的成本页上也列着:缓存命中每百万 token 0.003 美元,未命中 0.15 美元,输出 0.60 美元。工作日(中国法定节假日除外)北京时间 09:00–12:00 和 14:00–18:00(UTC 01:00–04:00 和 06:00–10:00)价格翻倍。169 次交付按闲时价合计 18.45 美元。(成本页上那个 0.125 美元的中位数是更早的一组样本:9 月 22 日到 24 日 orbi 仓库的 20 个 PR。)用量记录里每次交付只有一个总数,没有每次请求的时间,分不出高峰和闲时,所以这些记下的部分,实际花费在 18.45 美元到它的两倍之间,中位数在 0.082 到 0.163 美元之间。
这 18.45 美元只算了每次交付的最后一次尝试。把其中有 token 数的 3 次更早尝试加回来,169 次合并交付按闲时价一共 19.04 美元,平均每次 0.113 美元,比中位数高,是几次大交付把平均拉上去了。另外还有 16 个带 token 数、但没有由 Orbi 合并收尾的 issue(还开着、放弃了,或者最后由人接手),它们记下的所有尝试合计 2.73 美元。把没合并的也算进去,Cloud 记下的一共 21.77 美元,摊到 169 次合并上,按闲时价每次 0.129 美元,高峰价最多翻倍。
输入绝大部分是缓存读取。每次交付单独算缓存读取占输入的比例,中位数是 97.8%。Pi 会话里相邻的模型请求,开头大部分是一样的:系统提示词、issue、到目前为止的对话,直到 Pi 压缩上下文为止。provider 认得这段重复的开头(前缀),直接从缓存里拿。同样这 169 次记下的交付,要是全按未命中计费,闲时价也要 253 美元,而不是 18.45 美元。有了缓存之后,输出占了账单的一半左右:18.45 美元里有 9.46 美元。
为什么一直用 Pi
Orbi 8 月份第一批提交里就在调 Pi 了,当时没跟别的方案比过。回头看,没换掉它主要是两个原因。
第一个是换模型只要改配置。Pi 自带很多 provider,Orbi 还能把自己的 provider 文件合进每个 run 的那份 models.json,借此接上任何 OpenAI 兼容的端点(orbi#157)。生产上就是这么用的:Cloud 用量记录里的交付全跑在 deepseek-flash 上,迁到 Cloud 之前,我机器上的 runner 大多用同一条 Pi 命令跑两个 OpenAI 模型,gpt-5.6-luna 写代码,gpt-5.6-sol 审代码。再早一些,9 月份的 run 还走过 z.ai 和 Gemini。这几个模型和别的 agent 程序在同样任务上的对比,见 harness 测评。
第二个是换起来麻烦。Orbi 是照着 Pi 的命令行搭起来的,一个会话要的东西,skill、模型、扩展、会话目录,一条 pi --print 全装下。同一轮测评里,我们还用 Claude Code 跑了 Opus 5.5、用 zcode(一个自带命令行的编程 agent)跑了 GLM 5.3 flash。测评跑在我个人账号下的私有仓库里,没装 Orbi GitHub App,所以合并的 PR 不在那 373 个里。这两个 agent 都得写一层桥,把 Pi 的参数对到对方提供的参数上。结果两层桥都在半路把 --skill 列表弄丢了,那些会话一直是不带 Orbi 的 skill 在跑,后来才发现,9 月 29 日修好。harness 那篇标出了哪些结果是这样跑出来的。zcode 这层桥还跑过真实交付:9 月里有些时候,比如 25 日到 28 日的大部分时间,我机器上有的 runner 用它顶替了 pi,那几天的交付是 zcode 加 GLM 5.3 flash 写的,也没带 Orbi 的 skill。它们都跑在我机器上,不在 Cloud 的用量记录里。
Pi 留给用户的那一层,Orbi 放在哪
Pi 首页(2026 年 10 月 5 日看的)列了五样核心里不做的东西:子 agent、权限弹窗、plan 模式、待办、后台 bash。MCP 原本也在这张单子上,现在已经内置了。每一样 Pi 都给了自己补的办法:扩展、第三方包、容器、写文件或 tmux。这五样 Orbi 一样都没往 Pi 里加,其中三样有近似的做法。
| Pi 核心里没有的 | Pi 建议的补法 | Orbi 里最接近的东西 |
|---|---|---|
| 权限弹窗 | 容器,或做一个确认用的扩展 | 合并闸门。它管什么能合并,管不到一次工具调用能碰什么。 |
| 子 agent | 用 tmux 起多个 Pi,或扩展、第三方包 | runner 按角色另起独立的 Pi 会话。 |
| plan 模式 | 把计划写进文件,或扩展、第三方包 | 动代码前先写的 .orbi/plan.md,Pi 压缩上下文后会话会重读它。 |
| 待办 | TODO.md,或扩展 |
会话里没有。 |
| 后台 bash | tmux | 没有。交付会话不跑常驻进程。 |
先说权限。每张 issue 有自己的 git worktree,从 runner 认领时记下的 base 提交建出来。实现会话停在 commit,runner 推送、开 PR,再合并评审通过的那个 head。base 前移,Orbi 在两个地方处理:评审会话开始时分支已经落后,它会先把新 base 合进来,13:41 就是这样;评审期间 base 有了新提交、又能无冲突合并,runner 会自己把新 base 合进分支,等新 head 的 CI 跑完就合并 PR,不重新评审。合在一起之后的结果没人审过,只靠新 head 上的 CI 兜底,这是我们接受的取舍。不管哪种,最后的 gh pr merge --match-head-commit 都要求分支 head 正好是 runner 预期的那个提交,对不上就拒绝合并。
这些都限制不了一次工具调用在机器上能做什么。Pi 的安全文档说工作目录不是安全边界,建议用容器或沙箱。在 Orbi Cloud 上,每个租户的 runner 是一个独立的系统用户,有自己的资源配额,这道边界比 Pi 推荐的容器弱。
子 agent 那一行,Orbi 的做法是由 runner 自己起会话。runner 由 systemd 定时器(macOS 上是 launchd)每 5 分钟拉起一次,长时间没有输出的会话会被终止(orbi#94)。现在的阈值比下面第一个事故里的 15 分钟长:等模型响应时是 30 分钟,其他情况大约一小时,再加一段宽限期,才会终止会话。systemd 日志、issue 评论和 PR 上挂的是同一个 run_id,一次 run 能从头查到尾。
为什么放在 Pi 外面,不做成扩展
runner 做的这些事,大多能写成 Pi 扩展,我还是放在了 runner 里。
要是合并闸门是实现会话里的一个扩展,闸门跑不跑就取决于这个会话的配置。在 Orbi 里,Pi 会话只交出 commit 和评审结论,合不合由 runner 定。不过评审并不完全独立:评审会话发现问题会自己修、推到任务分支,修完说没问题的还是它自己。它不做合并:提示词里写着不许合,合并由 runner 来做。这只是分工,算不上权限隔离,评审会话手里有工具,跟 runner 在同一个环境里跑。
闸门不在 Pi 里,Orbi 才能让每个实现和评审会话都带 --no-extensions 启动,又不会把闸门一起关掉。这个参数为什么要紧,看下面第一个事故。
将来要是换 agent,要动的只有命令行那一层,但上次丢 skill 的正是这一层。Claude Code 和 zcode 那两层桥,走的也是跟 Pi 同一套 worktree、评审和合并闸门。
两次事故
第一次是扩展惹的祸。9 月 4 日晚上,run 开始卡住,卡在 Pi 发出第一个模型请求之前,z.ai 上有,Gemini 上也有。每个都干等 15 分钟,直到空转检测把它杀掉、把 issue 标成 ai-blocked。卡住的 pi 进程活着,但几乎不动,两分半钟只用了 2 秒 CPU;没有任何连到模型 API 的 TCP 连接,唯一的 socket 连着当前用户的 D-Bus;会话目录是空的,Pi 连会话文件都还没建。同样的配置在 shell 里手动跑,连续 20 多次都正常。systemd 用户服务拉起来的 run 不是每个都卡,但卡住的都是它拉起来的。在 Linux 上碰到类似症状,可以把下面这段存成 pi-hang.sh,用运行 pi 的那个用户执行,传入 pi 进程的 pid 和任务 worktree 来确认。在 Cloud 上,pi 进程是 Orbi 日志里 process_spawned 那一行所记 pid 的子进程。
# 用法:bash pi-hang.sh <pi 进程的 pid> <任务 worktree>
PID=$1 WT=$2
[ "$(ps -o comm= -p "$PID" 2>/dev/null)" = pi ] || { echo "$PID 不是正在运行的 pi 进程"; exit 1; }
ls "/proc/$PID/fd" >/dev/null 2>&1 || { echo "请用运行 pi 的那个用户来跑"; exit 1; }

# 1. 进程活着但不干活:状态 S,CPU 接近 0
ps -o pid,stat,%cpu,wchan:32 -p "$PID"

# 2. 查看这一刻的 TCP 连接(我们那次一个都没有)
tcp=$(ss -tnpH) || { echo "ss 执行失败"; exit 1; }
grep "pid=$PID," <<<"$tcp" || echo "这个 pid 没有 TCP 连接"

# 3. 它的 unix socket 连到了哪里(我们那次是 /run/user/1000/bus)
unix=$(ss -xpH) || { echo "ss 执行失败"; exit 1; }
awk -v p="pid=$PID," '$0 ~ p {print $8}' <<<"$unix" |
  while read -r peer; do awk -v i="$peer" '$6 == i {print $5}' <<<"$unix"; done

# 4. 会话文件建出来没有(我们那次是空的)
ls -la "$WT/.pi-session/"
原因是一个装在用户级别的 Pi 扩展包 pi-mcp-adapter。它启动时通过 D-Bus 向桌面的 Secret Service 要钥匙串,在 systemd 用户服务里,这个请求有时永远等不到回应。为什么会这样,我们没再往下挖。把它从 ~/.pi/agent/settings.json 里去掉,同一个 run 15 秒就拿到了第一个模型响应(排查过程见 orbi#311)。长期的修法是 orbi#249,这张票 9 月 3 日就开着,9 月 8 日合入:实现和评审会话一律带 --no-extensions 启动,只加载 Orbi 配置里列出的扩展。它只管扩展,这一点跟下一个事故有关。
第二次是 runner 跑错了模型。9 月 20 日我新配了一个 runner,本来要通过 Pi 用 GPT。配置里写了仓库,却漏了 pi_provider 和 pi_model,Orbi 就没传 --provider 和 --model,Pi 退回去用这个系统用户 ~/.pi/agent/settings.json 里的 defaultModel,这一项 #249 没管。我以为它是 GPT runner。Orbi 的日志会在会话启动时记下实际用的 provider 和模型,那一行写的却是 provider=LLAMA_INTRANET model=qwen3.8:27b,一个本地模型。没有任何报错,唯一的线索就是那一行,好在我当天就看到了。现在每个 runner 的配置都写明 provider 和模型。这是约定,Orbi 不强制检查,所以实际跑的是哪个模型,看启动行,不看配置。
如果你也想无人值守地跑 Pi
下面几条只说 Pi 特有的。谁认领、谁评审、谁合并这类问题,写在无人值守地跑 Claude Code 里,换成 Pi 也适用。
- 每个 run 给一个单独的
--session-dir。agent 做过什么,完整记录都在里面,token 用量也在,出了事看最后几条,比报错信息清楚。 - 从
--no-extensions开始,用--extension(简写-e)一个一个加回来。不然账号下装的东西会被带进一个没人盯着的 run。这个参数也会关掉 Pi 的内置扩展,包括 MCP 和 Codemode,需要的话用--extension builtin:mcp或--extension builtin:codemode加回来。扩展加回来以后,Codemode 这个工具默认还是关的,有两种办法打开:连上一个 MCP server(它默认就用 Codemode 方式暴露工具,连上时 Pi 会自动打开 Codemode),或者自己在 Pi 的设置里写"defaultTools": ["+codemode"],Orbi Cloud 的 runner 就是这么设的。用--tools也行,但它会替换整个工具列表,默认的那几个工具要一起写上。 - 某个角色一定不能看到某个 skill,就传
--no-skills,再把要用的 skill 逐个列出来。--skill只是在 Pi 自动发现的 skill 之外再加:用户的 skill 目录总会被发现,仓库里的要等 Pi 信任这个项目之后。 - provider 和模型写在命令行上。不写的话,Pi 会按设置和它能看到的模型自己挑一个;我们那次挑中的是保存的
defaultModel。 - 盯住不出声的会话。卡住的会话不会退出,上游收不到报错。看会话文件最后一次变大是什么时候,也看启动一分钟后会话文件到底建出来没有。
- 想绕开 Pi 的某个限制之前,先读你那个版本的文档。我们为一个 Pi 根本没有的限制写了绕行代码,结果把 API key 写到了磁盘上。
系列接下来写什么
下一篇写为什么每张 issue 都在自己的 worktree 里单独起 Pi 会话,再往后写 Orbi 加载了哪些 Pi skill、为什么。模型对比在 harness 测评的第一篇和第二篇里。
Orbi 的代码在 orbi-build/orbi。Orbi Cloud 跑的是同一个 runner、同样的 Pi 会话,接上你自己的仓库就能用。