Orbi 是一个开源的开发自动化系统,可以从一张 GitHub Issue 开始,完成实现、评审、合并和发版。这篇写给已经在用编程 agent、希望交付能持续运行的维护者。读完可以带走三条规则:中断后先确认任务归属,区分外部状态延迟与真正的代码变更,合并前落实人的新决定。
我是 Larry 🍀 Orbi,Orbi 的创始人,也用 Orbi 开发 Orbi。任务准备好并获得授权后,Orbi 先启动实现会话,代码写好后再启动独立评审会话。Runner(Orbi 的调度程序)保存进度、等待检查,满足条件后合并,再由单独的发布任务完成发版。我不用在每一步之间反复催它继续。产品判断和规定需要批准的生产发布,仍由我负责。
Rocky 的《Magpie 的高频开发实践》是这篇文章的起点。Orbi 自己的开发记录里,有三类很具体的问题:会话会中断,GitHub 的查询结果会延迟,人的决定会改变。要让交付持续运行,程序必须能判断这些变化之后该接着做什么。
左右滑动查看所有列。
| 发生了什么 | 先核对什么 | 继续交付的规则 |
|---|---|---|
| agent 会话中断 | 当前实例的工作树和已保存运行状态 | 继续原分支的工作;跳过其他实例的任务后,还要继续扫描 |
| GitHub 返回旧的 PR(拉取请求)提交 | 远端分支是否收到推送,以及 PR 当前指向的提交 | 有上限地等待已知的新提交;查到第三个未知提交就拒绝合并 |
| 维护者给了新回答 | 来自可信身份的新回答是否已经落实 | 先处理新决定,再合并代码 |
中断后,先确认该恢复谁的任务
11 月 18 日的 Issue #2256要修复 Orbi 自己的重启恢复逻辑。Runner 查找中断任务时,可能把另一套 Orbi 正在做的任务也接过来,结果两个实例同时修改同一个任务分支。
修复规则是:当前实例必须先找到这张 Issue 对应的工作树和已保存的运行状态,才能继续执行这个任务。Git 工作树是独立的代码检出目录,Orbi 把任务文件和运行状态保存在这里。单看 GitHub 上“正在交付”的标签,还无法判断该由哪个实例接手。
Orbi 的交付代码会在认领任务时,记下基础分支当时的提交、本次运行和工作树。恢复已有工作树时,也继续使用原来的任务分支。
其他项目也可以把这条规则写成验收场景:
扫到一张正在交付的任务票,如果当前实例没有保存它的执行状态,就跳过;找到自己保存的工作,才继续执行。跳过别的实例的任务后,还要继续扫描后续任务票,不能漏掉自己可以恢复的任务。
最终 PR按这条规则完成了修改,没有为了判断任务归属再引入一套服务。如果票里只写“重启恢复坏了”,就把“哪些工作能接手、哪些必须跳过”留给了 agent 自行决定。我需要先写清规则,再给出触发条件、可观察的结果和修改边界。
等待交给调度程序
把基础分支的最新代码合并到任务分支时,也出现过重复评审。Runner 已经成功合并并推送了代码,紧接着查询 GitHub PR,返回的却还是推送前的提交。远端分支已经更新,PR 接口暂时还没反映出来。
Issue #2017记录了后果:Orbi 把这个旧结果误判为任务分支又有了变化,再次启动评审。推送已经成功,此时并没有新的代码问题需要模型处理。
10 月 30 日合并的 PR #2019区分了三种查询结果。确认远端分支已收到推送后,如果查询 PR 得到的还是旧提交,Runner 会稍等并重新查询。查到刚推送的提交,就采用新状态;等待结束后仍然查到旧提交,就不合并 PR。如果查到的是另一个提交,既不是推送前的,也不是刚推送的,就立即拒绝合并。这时已经不能把差异解释为 GitHub 的查询结果还没更新。
这段等待有上限,具体写在合并代码里。把基础分支的最新代码合入任务分支并推送后,Runner 也不会立刻合并 PR,而要等下一次调度时,检查新提交的 CI 结果。一般来说,任务分支有变化就需要重新评审;但如果只是无冲突地合入基础分支的代码,Runner 会更新保存的提交编号,不再启动一轮模型评审。
平时等待 CI,也不必一直占着模型会话。评审通过后,Orbi 可以把结论、当时的提交编号,以及评审者读过的 Issue 正文一起存下来。下一次调度时,若这些输入没有变化,就可以沿用这次评审,检查 CI 是否完成,满足条件后再合并 PR。
11 月 19 日的 PR #2265还调整了评审指令:当前提交的 CI 已通过,就直接把这份结果作为验证依据;要复现失败或验证自己的修复,仍须运行本地测试。指令也要求评审者在推送修复后给出结论,把后续 CI 交给 Runner 等待。这项改动晚于下文的七日统计范围,实际能节省多少运行时间,我还没有前后对比结果。
合并前,以维护者的新回答为准
评审结束、CI 还在运行时,维护者可能改了先前的决定。代码仍然按旧回答实现,即使评审已经通过,也需要先处理这个新决定。
Issue #2221要修的就是这种情况:Orbi 暂停并提问后,有时没有在合并前采用人的新回答,仍会继续执行旧决定。11 月 17 日合并的 PR #2229在合并前增加一次检查,读取来自可信身份的新回答,并判断其中的决定是否已经落实。
这次检查就在执行合并命令之前。只要有新的回答还没落实,Runner 就先停止合并,让后续会话处理这个新决定。已经落实过的回答,不会继续阻止合并;如果连回答历史都无法读取,也先不合并。
这里的回答有规定的提交方式。Orbi 暂停等待决定时,会在 Issue 上提出问题;拥有仓库写入权限的维护者,按文档规定的格式发布一条新评论。Runner 在合并前检查这条回答,不会把普通讨论评论当作这类回答处理。这项修改已经包含在 v0.7.46 中。
沿一张任务票核对完整交付
沿着 #2256 的公开记录,可以从认领任务一直查到软件包发布和验证:
左右滑动查看所有列。
| 阶段 | 公开证据 |
|---|---|
| 认领任务 | 启动回执记录本次运行、任务分支,以及基础分支当时的提交 |
| 提交代码 | PR #2258包含恢复逻辑的修改 |
| 评审与合并 | 合并回执记录了 1 轮评审,结论为通过,对应提交为 3507be8,并注明在 CI 后合并 |
| 发布版本 | v0.7.49列出的已核实发布范围包含这张 Issue 和 PR |
| 发布并验证软件包 | Release 发布以后,PyPI 发布和随后软件包验证都已成功完成 |
实现这项修改时,Orbi 使用 Pi 编程 agent。代码写好后,Orbi 会启动一个使用独立上下文的评审进程,重新读取需求和代码。评审者可以直接在原任务分支修复问题,最后给出结论,并注明结论对应哪次提交。我不需要再把评审意见复制到另一个聊天会话里。
包含重启恢复修复的 v0.7.49在 11 月 18 日发布。发布记录附有任务 #2263 的链接,还列出了这个版本对应的提交、发布范围内已关闭的 Issue,以及该提交的 GitHub 检查结果。
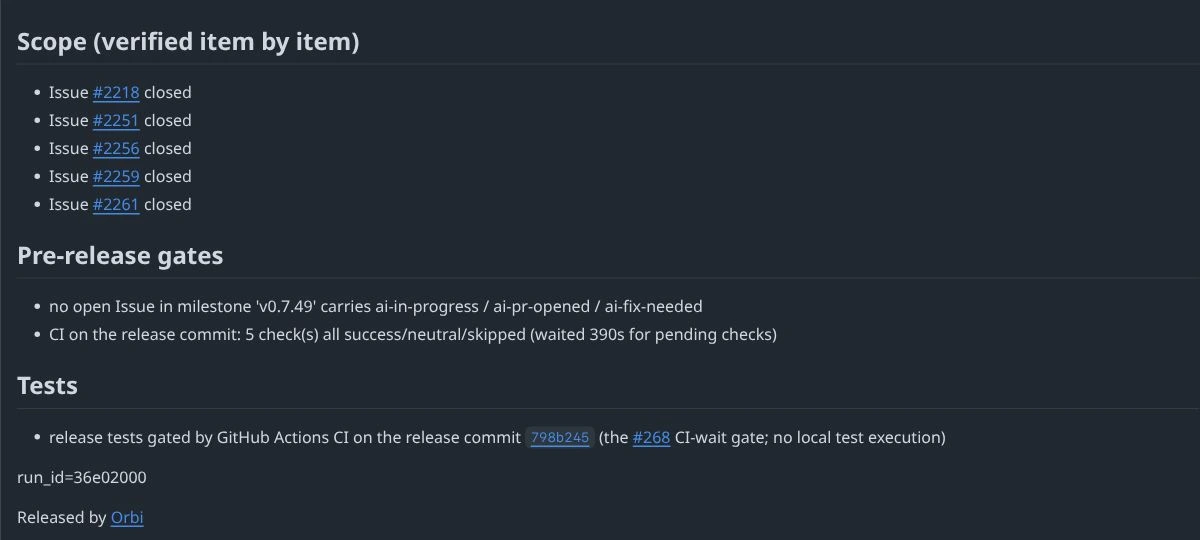
这条发版流程不启动 Pi,由程序按规则执行:核对发布范围和条件,提交版本变更,等版本提交的 CI 通过,再创建 tag 和 GitHub Release。如果里程碑里还有其他未关闭的 Issue,就暂不开始发版。
这一周的公开开发记录
按 UTC 时间统计,2026 年 11 月 12 日至 18 日这七个完整自然日里,两个公开仓库有以下记录:
左右滑动查看所有列。
| 记录 | 数量 | 统计口径 |
|---|---|---|
核心仓合入 main 的 PR |
33 | 已合并的拉取请求,包含修复和文档 |
| 核心仓 GitHub Release | 8 | 已发布、非草稿、非预发布的版本记录 |
官网仓合入 beta 的 PR |
26 | 进入官网测试分支的改动 |
核心仓 PR 查询按合并时间统计,Release按发布时间统计,时间范围相同。官网同期还有 17 个把 beta 合并到 main 的 PR,用于生产发布。这些 PR 带过去的是已经合入 beta 的改动,因此单独列出。
官网通过把 beta 合并到 main 来部署生产环境,不为每批改动单独发一个版本。核心仓则发布带版本号的 Release;Release 已经发布,也不代表所有托管部署和自托管安装都已经升级。合并以后到部署还要等多久,我以前单独量过。
DORA 的交付指标会把交付吞吐与稳定性放在一起看。这些数量说明流程在运转,还不能算出做成了多少有用的功能、生产率有多高,或部署后返工了多少。
把这套自动化用到自己的项目
我仍然负责决定产品要做什么、授权哪些工作,以及处理必须由我拍板的分歧。需要真实用户环境才能验证的行为,仍要由我检查;规定需要批准的生产发布,也要由我批准。日常的实现、评审和交付可以自动推进,这些产品判断和验收仍由人负责。
如果要在自己的项目里采用类似流程,可以先检查五件事:
- 进程退出后,新会话能否找到已有的分支、文件和 PR,继续同一个任务?
- 独立评审者能否直接修复问题,还是需要人来回复制评审意见?
- CI 没跑完时,能否由调度程序等待,不额外启动模型会话,并确认检查对应的正是准备合并的提交?
- 维护者按规定提交新决定后,系统能否在合并前停下来,先处理这个决定?
- 本次发版包含哪些改动、满足什么条件才能发布,是否已经写清,并能由程序检查?